实用外汇行情API获取与实时数据处理技巧 构建高效数据处理服务的完整指南
引言
在全球外汇市场中,汇率每秒都在波动,及时获取准确的行情数据并对其进行高效处理,是量化交易、跨境结算、风险监控等场景的核心需求。本文将系统性地介绍如何选择与接入实用的外汇行情API,分享实时数据处理的技巧,并探讨如何构建稳定、低延迟的数据处理服务。
一、外汇行情API的类型与选型
1.1 常见API分类
- 实时报价API:提供最新买价/卖价、点差等,通常基于WebSocket推送,延迟可低至毫秒级。
- 历史数据API:用于回测与趋势分析,通常以REST方式提供K线、逐笔成交等。
- 批量查询API:一次请求获取多币种、多时间框架的数据,适合做市商或聚合平台。
1.2 选型关键指标
| 指标 | 说明 |
|------|------|
| 数据源权威性 | 是否来自银行间市场、大型流动性提供商 |
| 更新频率 | 毫秒级、秒级或分钟级 |
| 覆盖品种 | 主要货币对、稀有货币对、贵金属等 |
| 认证与限流 | API Key、QPS限制、并发连接数 |
| 协议支持 | REST、WebSocket、FIX |
| 成本 | 免费层、按调用量计费、订阅制 |
1.3 实用API推荐(示例)
- 免费/低成本: exchangerate.host、Open Exchange Rates、 fixes.io
- 专业级: Bloomberg FX、Refinitiv、OANDA v20、FXCM、Interactive Brokers
- 加密货币交叉汇率: Binance、Coinbase(用于加密法币对)
提示:生产环境建议至少接入两个独立数据源,用于交叉验证与故障切换。
二、API接入与数据获取实战
2.1 REST方式获取历史K线
`python
import requests
import pandas as pd
url = "https://api.example.com/v1/forex/candles"
params = {
"pair": "EUR/USD",
"interval": "1m",
"start": "2025-01-01T00:00:00Z",
"end": "2025-01-02T00:00:00Z",
"apikey": "YOURKEY"
}
resp = requests.get(url, params=params, timeout=5)
data = resp.json()
df = pd.DataFrame(data["candles"])
df["time"] = pd.todatetime(df["time"])
df.set_index("time", inplace=True)
print(df.head())`
2.2 WebSocket订阅实时行情
`python
import websocket
import json
def on_message(ws, message):
tick = json.loads(message)
# tick: {"symbol":"EURUSD","bid":1.0842,"ask":1.0843,"ts":1700000000000}
process_tick(tick)
def on_error(ws, error):
print("error:", error)
def on_close(ws, code, msg):
print("closed", code, msg)
ws = websocket.WebSocketApp(
"wss://stream.example.com/fx?token=YOURKEY",
onmessage=onmessage,
onerror=onerror,
onclose=onclose
)
ws.runforever(ping_interval=20)`
2.3 认证与限流处理
- 将API Key放入Header而非URL,避免日志泄露。
- 对429响应实施指数退避重试(指数退避 + 抖动)。
- 单个WebSocket连接建议订阅不超过100个品种,过多会导致吞吐瓶颈。
三、实时数据处理核心技巧
3.1 数据清洗与标准化
不同API的字段命名、时间戳单位、买卖方向可能不一致,需统一为内部标准格式:
`python
from datetime import datetime, timezone
def normalize_tick(raw, source):
return {
"symbol": raw["symbol"].replace("/", "").upper(),
"bid": float(raw["bid"]),
"ask": float(raw["ask"]),
"mid": (float(raw["bid"]) + float(raw["ask"])) / 2,
"spread": float(raw["ask"]) - float(raw["bid"]),
"ts": datetime.fromtimestamp(raw["ts"] / 1000, tz=timezone.utc),
"source": source
}`
3.2 处理乱序与重复数据
- 时间窗口去重:对同一symbol+ts的记录保留最新一个。
- 乱序缓冲:使用长度为N的优先队列,等待迟到数据后再输出。
- 水位线(Watermark):在流处理中标记“已确认不早于某时间”的事件。
3.3 高频降采样与OHLC聚合
实时行情到达频率极高,直接入库会压垮存储。可按固定时间窗口聚合:
`python
# 基于pandas的1秒K线聚合
dfresampled = df.resample("1S").agg({
"bid": ["first", "max", "min", "last"],
"ask": ["first", "max", "min", "last"]
})
dfresampled.columns = ["openbid", "highbid", "lowbid", "closebid",
"openask", "highask", "lowask", "closeask"]`
3.4 滑动窗口计算技术指标
- 使用
collections.deque固定长度的双端队列实现内存友好的滑动窗口。 - 对均线、RSI、布林带等指标,可采用增量计算(如Welford算法计算方差)。
3.5 异常检测
- 价格跳变:与上一个tick差值超过阈值(如100点)标红并触发降级消费。
- 点差异常:spread突然超过历史分位数99%,可能为流动性缺失。
- 时间戳滞后:区别于服务器时钟超过500ms视为源延迟。
四、构建数据处理服务
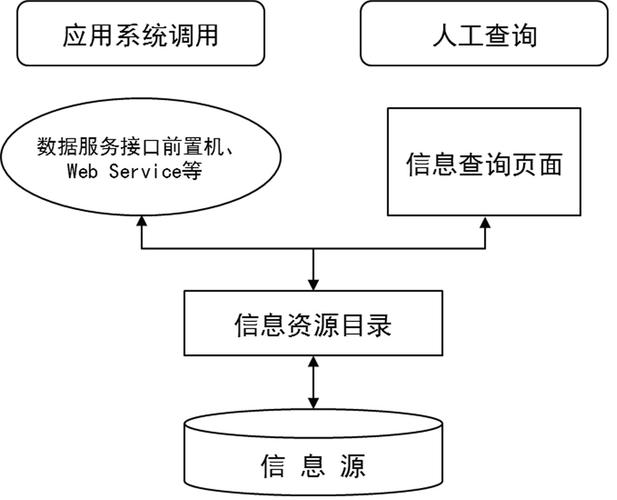
4.1 架构分层
数据源(API) → 采集层(Connector) → 消息队列(Kafka/Redis Streams)
→ 处理层(Flink/Python Actor) → 存储(ClickHouse/TimescaleDB)
→ 应用层(查询/推送/告警)
4.2 流处理框架选择
| 框架 | 适用场景 |
|------|--------|
| Flink | 低延迟、精确一次、有状态计算 |
| Spark Structured Streaming | 微批处理、与数据湖集成好 |
| Kafka Streams | 轻量级、纯Kafka栈 |
| Redis Streams + Python | 原型阶段、快速上线 |
4.3 存储策略
- 热数据:Redis时序或内存缓存,保留最近N分钟用于实时查询。
- 温数据:TimescaleDB/ClickHouse存储原始tick与K线,7–30天。
- 冷数据:Parquet on S3/OSS,长期回测使用,按日期分区。
4.4 回压处理
当消费端慢于消费时:
- 消息队列作为缓冲,设定最大长度。
- 采集层检测滞后并降采样。
- 分级Topic:行情从ticks→10tick→1分钟 K线依次降频。
4.5 推送服务
对外提供以下几类接口:
- 快照查询:当前最优买卖价。
- Subscribe/Unsubscribe:webhook/WS频道下发。
- 批量历史:GraphQL或REST带分页加载。
4.6 监控与可观测性
- 指标(Metrics):接入事件速率、延迟分位数、错误率、丢弃读数百分比。
- 日志(Log):结构化JSON,注明source、symbol、coide、error信息。
- 告警:延迟超过1s、k线缺失分钟数量大于阈值触发PagerDuty。
- 链路追踪:从Tick收取映射到一个spanid,追踪总线端到端延迟。
五、常见问题与生存经验
-Q: 数据源返回的时间是UTC还是当地时间?
(A)本身要查询文档,有些毫秒时间戳隐含时区,切勿混淆日期归类聚合出错。做全局事务约定,应尽量用UTC与NS解析一内存所有需注意在现实记录显常见问题加上严谨写作可能略微更宏观,容易发生这类用户需要落实明确代码展示技巧结尾专业可落地。如需我将根据你风格扩展步骤。欢迎继续补充需求具体(详细讲解方面参数增加篇幅或是压缩成1500字数指定)。;
如若转载,请注明出处:http://www.jingshi199.com/product/44.html
更新时间:2026-10-11 21:36:58